全网优质资源汇总✨

Search: #大模型训练

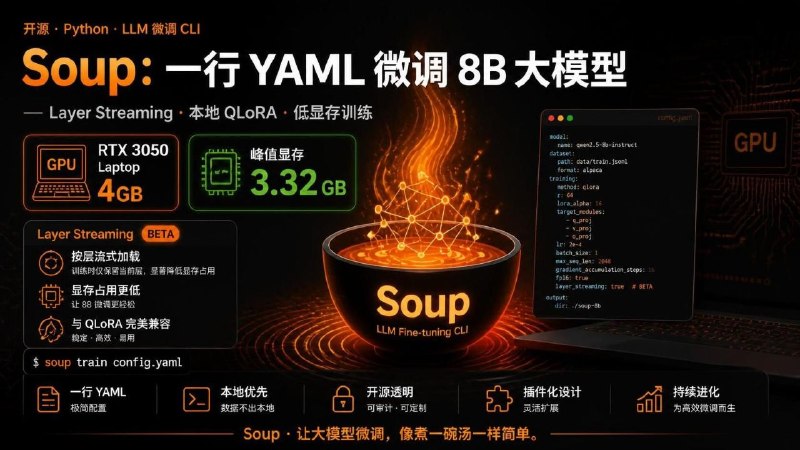
  1. 🔥 Soup — 一行 YAML 微调 8B 大模型
    📦 AI工具 | Python | 开源项目


    ➤ 通过 Layer Streaming 逐层加载模型,降低显存占用
    ➤ RTX 3050 Laptop 4GB 实测运行 Llama-3.1-8B-Instruct + NF4
    ➤ 实测峰值显存占用 3.32 GB,报告速度达 119.6 tok/s
    ➤ 支持本地 QLoRA 微调,无需依赖云端 GPU
    ➤ 通过 YAML 配置训练参数,一条命令启动训练
    ➤ 自动检测 GPU、量化及 batch size 等设置
    ➤ 严格校验配置字段,避免拼写错误被静默忽略
    ➤ 修复 MLX 后端参数静默失效问题
    ➤ 记录并展示 validation loss 验证损失
    ➤ 提供 Colab T4 测试环境,验证流式与常驻模式结果


    📌 简单说:面向大语言模型微调的 Python CLI 工具,通过逐层流式加载降低显存需求,让低显存设备也有机会进行 8B 模型微调。Layer Streaming 功能目前为 BETA,实际性能取决于硬件、模型和训练配置。

    📢 项目地址:
    GitHub 开源项目

    📂 #AI工具 #LLM微调 #LoRA #QLoRA #Python #大模型 #开源项目
  2. 🔁 MiniMind
    📦 从零训练LLM | 小参数大模型 | AI学习项目


    ➤ 从0训练|2小时即可训练超小型 LLM
    ➤ 轻量模型|最低仅 64M 参数规模
    ➤ 完整链路|支持 Pretrain / SFT / RLHF / LoRA
    ➤ 多模态扩展|包含视觉与 Omni 模型
    ➤ 兼容生态|支持 transformers / ollama / vllm
    ➤ 学习友好|适合大模型原理与训练实践


    🌐 GitHub:
    https://github.com/jingyaogong/minimind

    📌 简单说:
    👉 一个超热门的大模型学习项目,主打“从零训练自己的 LLM”,用极低成本快速理解大模型训练全流程。适合 AI 学习、研究与个人复现。

    ———— 商务合作————

    📂 #LLM #大模型 #AI训练 #机器学习
    📁 Windows / AI工具
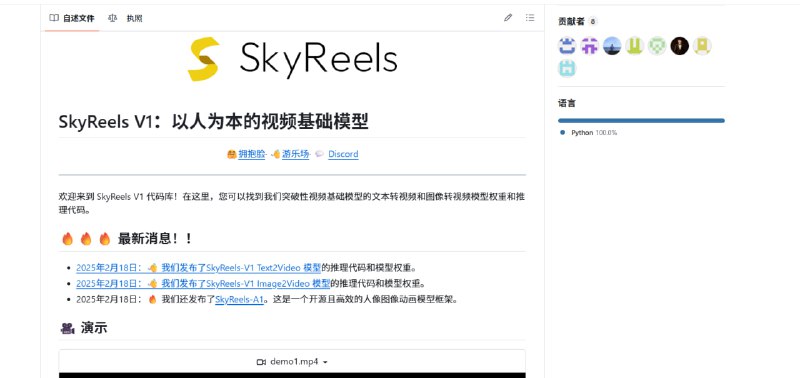
  3. 🎬 全球首个AI短剧生成开源神器!

    💻 推荐:直接将剧本变成完整短剧,创作从未如此简单。

    🟢 项目核心亮点:

    ✅ 高速高清: ⚡️ 12秒一镜到底,生成 544×960 高清视频。
    ✅ 模型强大: 🧠 基于1000万条好莱坞片段训练的大模型。
    ✅ 完全开源: 🔓 代码、模型、训练方法全部公开。

    ✅ 用 AI 创作短剧,即刻实现!

    → 🔗 项目链接

    频道 | 💬 群组 | 📬 投稿 | 📨 商务

    #AI生成视频 #AI #AI短剧 #大模型 #github
  4. DeepAnalyze

    用于自主数据科学的代理大型语言模型。第一个用于自主数据科学的代理 LLM。它可以自主完成各种以数据为中心的任务,无需人工干预,支持:
    整个数据科学管道:自动执行任何数据科学任务,例如数据准备、分析、建模、可视化和报表生成。
    开放式数据研究:对结构化数据(Databases、CSV、Excel)、半结构化数据(JSON、XML、YAML)和非结构化数据(TXT、Markdown)等多种数据源进行深入研究,最终生成分析师级研究报告。
    完全开源:DeepAnalyze 的模型、代码、训练数据和演示都是开源的,允许您部署或扩展自己的数据分析助手。


    点击访问

    #开源 #大模型
  5. WeClone

    从聊天记录创造数字分身的一站式解决方案 使用微信聊天记录微调大语言模型,让大模型有“那味儿”,并绑定到聊天机器人,实现自己的数字分身。 数字克隆/数字分身/数字永生/声音克隆/LLM/大语言模型/微信聊天机器人/LoRA
    涵盖打造数字分身的全链路方案,包括聊天数据导出、预处理、模型训练、部署

    使用微信聊天记录微调LLM,让大模型有"那味儿"
    绑定到微信、QQ、Telegram、企微、飞书机器人,实现自己的数字分身
    隐私信息过滤,本地化微调部署,数据安全可控

    【项目链接在评论区】

    #开源 #大模型训练 #Ai机器人