全网优质资源汇总✨

Search: #本地大模型

  1. 🤖 Strata — 消费级电脑本地运行大型 AI 模型
    📦 AI 工具 | Windows / Linux / macOS | 开源项目


    ➤ 基于 C++ 构建的高性能本地 AI 推理引擎,支持在个人电脑上运行大型模型
    ➤ 支持 Qwen3.8-Flash-Next 125B 参数级 MoE 模型,实际性能取决于硬件与量化配置
    ➤ 兼容 NVIDIA、AMD 显卡及 Apple Mac 统一内存架构
    ➤ 提供 OpenAI / Anthropic API 兼容接口,可对接 Claude Code、Cursor、Chatbox 等工具
    ➤ 支持图片输入、多模态理解、长文档处理与代码生成
    ➤ 提供自动化安装脚本,可辅助检测硬件、下载模型并启动本地服务
    ➤ 支持 SSD 模型加载,降低大型模型部署的操作门槛


    📌 简单说:
    👉 将大型 AI 模型部署在自己的电脑上,减少对云端 API 的依赖,同时增强数据隐私与本地运行能力。

    💻 硬件提示:
    ➤ 大型模型对内存、显存和存储空间要求较高。
    ➤ 125B 参数模型能否运行及运行速度,取决于量化精度、内存容量、显卡配置和模型架构。
    ➤ 32GB / 64GB 内存不代表一定能流畅运行 125B 模型,实际需求应以项目文档和具体模型配置为准。

    📢 项目地址:
    GitHub — Strata

    📂 #Strata #本地大模型 #AI推理 #LLM #MoE #开源项目 #本地部署 #AI编程
  2. 🤖 kimi-k3-in-c

    📦 AI 大模型 | 本地部署 | 开源项目


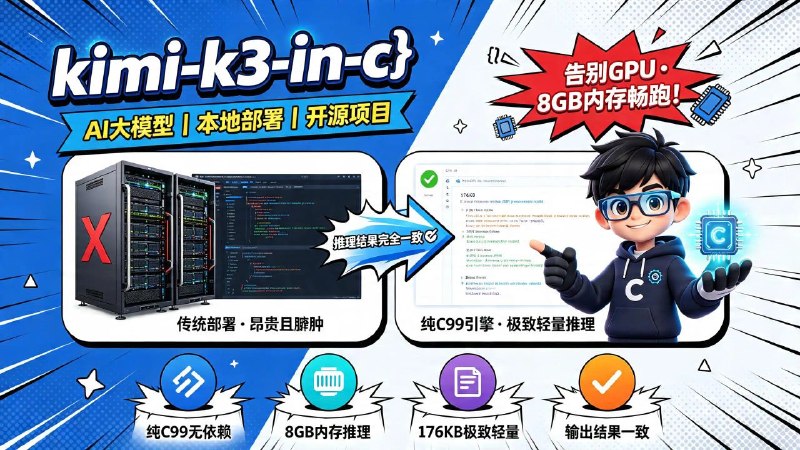
    ➤ 纯 C99 实现 Kimi K3 推理引擎
    ➤ 支持 2.78 万亿参数 MoE 大模型运行
    ➤ 无需 GPU、无需 PyTorch、无需 CUDA
    ➤ 仅需约 8GB 内存即可进行推理
    ➤ 推理结果与完整加载版本保持一致
    ➤ 引擎体积仅约 176KB
    ➤ 无外部框架依赖,极致轻量
    ➤ 支持 AVX2 CPU 加速
    ➤ 使用流式加载技术降低内存占用
    ➤ 专家缓存机制按需加载模型参数
    ➤ 支持 4-bit 专家权重优化
    ➤ 内存越低仅影响速度,不影响输出
    ➤ 提供完整测试套件
    ➤ 支持 Linux x86-64 环境
    ➤ 开源免费项目


    📌 简单说:
    👉 kimi-k3-in-c 是一个挑战硬件极限的开源项目,通过纯 C99 推理引擎和创新内存管理技术,让拥有 2.78T 参数的 Kimi K3 大模型能够在普通 CPU 和低内存设备上运行,展示了超大模型轻量化部署的可能性。

    ⚙️ 运行要求:
    ➤ Linux x86-64 系统  
    ➤ 至少 8GB 内存  
    ➤ 约 1.7TB 硬盘空间存储模型权重  
    ➤ 较快磁盘可提升运行速度  

    🔗 项目地址:
    https://github.com/FareedKhan-dev/kimi-k3-in-c

    📂 #AI #大模型 #KimiK3 #本地部署 #开源项目
  3. 🤖 Kimi-K3 国产大模型

    📦 AI大模型 | 开源项目 | 本地部署


    ➤ Kimi-K3 正式开源
    ➤ 支持本地部署运行
    ➤ 数据自主掌控,保障隐私安全
    ➤ 适用于企业私有化部署
    ➤ 支持 AI 应用开发与测试
    ➤ 开放模型权重,可自由研究使用
    ➤ 硬件成本约 2000 万级别
    ➤ 4000 万级配置可流畅运行


    📌 简单说:
    👉 Kimi-K3 国产大模型正式开源,支持本地化部署测试,适合企业及开发者搭建私有 AI 环境,提升数据安全与自主可控能力。

    🔗 项目地址:
    https://huggingface.co/moonshotai/Kimi-K3

    📂 #AI #KimiK3 #国产大模型 #开源项目 #本地部署
  4. 🤖 🔁 MNN LLM Android

    📦 本地大模型 | Android | 开源项目


    ➤ 手机上运行 AI 大模型
    ➤ 完全离线运行
    ➤ 无需互联网连接
    ➤ 内置多种模型可选
    ➤ 支持本地推理
    ➤ 开源免费

    ⚠️ 注意:

    ➤ 建议使用性能较好的设备。
    ➤ 模型越大,占用存储和内存越高。


    🌐 GitHub:
    https://github.com/alibaba/MNN

    📥 下载:
    https://github.com/alibaba/MNN/blob/master/apps/Android/MnnLlmChat/README.md#releases

    📌 简单说:
    👉 阿里巴巴开源的 Android 本地大模型应用,可在手机上离线运行 AI,无需联网即可进行聊天和推理。

    📂 #Android #AI #LLM #本地部署 #离线AI #开源
  5. 🤖 🔁 MiniCPM5-1B

    📦 开源大模型 | 本地部署 | GGUF


    ➤ 仅 1B 参数
    ➤ 支持 128K(131072 Tokens)超长上下文
    ➤ 支持 Think / No Think 双模式
    ➤ 支持 Agent 工具调用
    ➤ 支持代码生成
    ➤ 提供 GGUF、MLX、Transformers、vLLM、SGLang 等版本
    ➤ 支持 Ollama、LM Studio、llama.cpp 等本地部署
    ➤ 在多个 Sub-4B 开源模型评测中排名领先

    💡 适合低配置设备、本地 AI、Agent、代码开发等场景。


    🌐 Hugging Face:
    https://huggingface.co/openbmb/MiniCPM5-1B-GGUF

    📌 简单说:
    👉 MiniCPM5-1B 是 OpenBMB 推出的轻量级开源大模型,仅 1B 参数,却拥有接近甚至超越部分 7B 模型的综合表现,非常适合本地部署和低资源设备运行。

    📂 #AI #LLM #MiniCPM #GGUF #本地部署 #开源模型
  6. 🧠 🔁 LLM Torrent Models

    📦 AI模型资源 | 大语言模型下载 | 本地部署资源


    ➤ 提供部分难以查找的 LLM 模型资源
    ➤ 支持通过 Torrent 方式下载大型模型文件
    ➤ 适合本地运行 AI 模型的用户
    ➤ 可用于 Ollama / LM Studio / llama.cpp 等本地AI环境
    ➤ 适合寻找大体积模型、备份模型资源


    🌐 模型资源:

    1️⃣ CKPT:
    https://ckpt.cc/top

    2️⃣ HuggingBay:
    https://huggingbay.xyz/

    📌 简单说:
    👉 Torrent 下载适合大型语言模型文件分发,可以减少单一服务器压力,并方便用户获取大体积模型资源。社区也有通过 Torrent 分发开源模型的尝试。

    ⚠️ 注意:
    ➤ 下载前请确认模型许可证和使用权限
    ➤ 部分模型可能有商业使用限制
    ➤ 建议优先选择官方或可信来源模型仓库,例如 Hugging Face 等公开模型平台。
    ➤ 下载和分享资源时请遵守当地法律法规

    📂 #AI模型 #LLM #Torrent #本地AI #模型下载
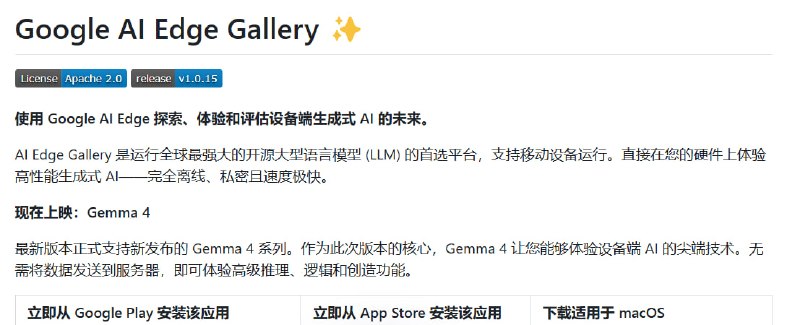
  7. 📱 🔁 Google AI Edge Gallery

    📦 端侧AI | 本地模型 | 离线生成式AI平台


    ➤ Google AI Edge 官方生成式 AI 体验平台
    ➤ 支持设备端运行大型语言模型(LLM)
    ➤ 完全离线运行,数据不上传云端
    ➤ 提供 Gemma 系列模型支持(如 Gemma 4)
    ➤ 面向移动设备优化(Android / iOS)
    ➤ 支持本地推理与低延迟生成
    ➤ 用于测试与评估端侧 AI 能力
    ➤ 支持多模型切换与实验性功能
    ➤ 强调隐私保护与本地计算


    🌐 GitHub:
    https://github.com/google-ai-edge/gallery

    📌 简单说:
    👉 Google AI Edge Gallery 是一个用于在手机或本地设备上运行大模型的官方平台,可以离线体验生成式 AI(如 Gemma),主打隐私、本地推理和低延迟 AI 体验。

    📂 #GoogleAI #EdgeAI #Gemma #本地模型 #LLM
    📁 AI平台
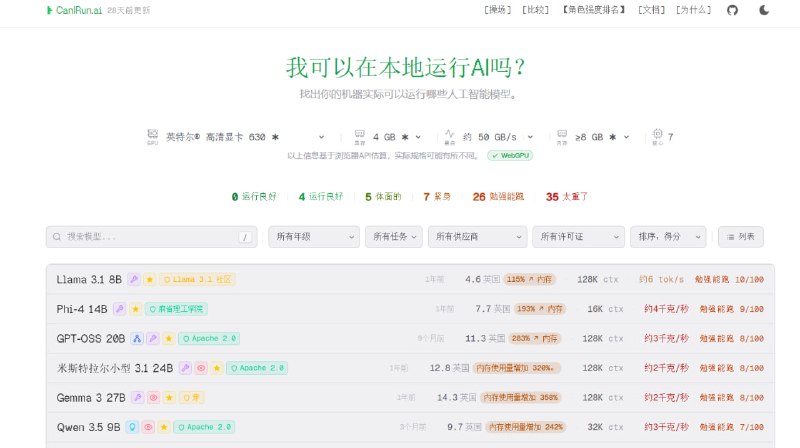
  8. 🧠 🔁 CanIRun.ai

    📦 本地AI检测 | 模型兼容性 | 硬件分析工具


    ➤ 通过浏览器自动检测本地硬件配置
    ➤ 分析 CPU / GPU / VRAM / 内存等关键指标
    ➤ 判断可运行的本地 AI 模型
    ➤ 支持 Llama、Qwen、Mistral、DeepSeek 等模型
    ➤ 显示模型运行等级(可运行 / 勉强运行 / 不支持)
    ➤ 基于 WebGPU / WebGL 等浏览器能力实现
    ➤ 无需安装软件,无需注册账号
    ➤ 纯前端运行,数据不上传服务器
    ➤ 适合本地部署 LLM 前的硬件评估


    🌐 官网:
    https://www.canirun.ai/

    📌 简单说:
    👉 CanIRun.ai 是一个“AI 版 Can I Run It”工具,打开网页即可自动检测你的电脑硬件,并告诉你哪些大模型可以在本地运行、运行效果如何,帮助你在下载或部署本地模型前做出判断。

    ⚙️ 特点:
    • 自动识别 GPU 与显存
    • 模型兼容性评分系统
    • 支持主流开源大模型库
    • 完全浏览器运行(隐私友好)
    • 零安装、即开即用

    📂 #CanIRunAI #本地模型 #LLM #AI工具 #硬件检测
    📁 AI工具
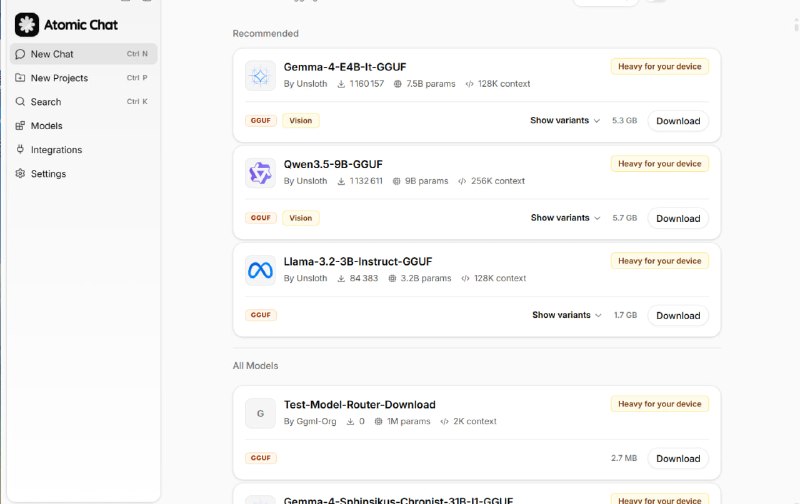
  9. 🔁 Atomic Chat
    📦 本地AI聊天 | 开源客户端 | 1000+模型


    ➤ 本地运行|数据始终保留在设备中
    ➤ 开源免费|无需订阅,无使用限制
    ➤ 1000+模型|支持 Qwen、DeepSeek、Llama、Mistral、Gemma 等
    ➤ 离线聊天|无需联网也可运行本地模型
    ➤ Agent支持|可创建和运行本地 AI 工作流
    ➤ 一键下载模型|支持 Hugging Face 模型库


    🌐 官网:
    https://atomic.chat/

    📌 核心特点:
    • 零成本使用
    • 无速率限制
    • 无云端依赖
    • 支持 GGUF、MLX、ONNX 格式
    • Windows / macOS / Linux / Android / iOS
    • 聊天记录与项目本地保存

    📌 简单说:
    👉 Atomic Chat 是一款开源本地 AI 聊天客户端,可在电脑或手机上直接运行各种大模型,无需订阅 AI 服务。支持 1000 多种模型下载与管理,数据不会上传到服务器,适合注重隐私和本地 AI 的用户。

    📂 #AI聊天 #本地AI #Llama #DeepSeek
    📁 Windows / macOS / Linux / Android / iOS
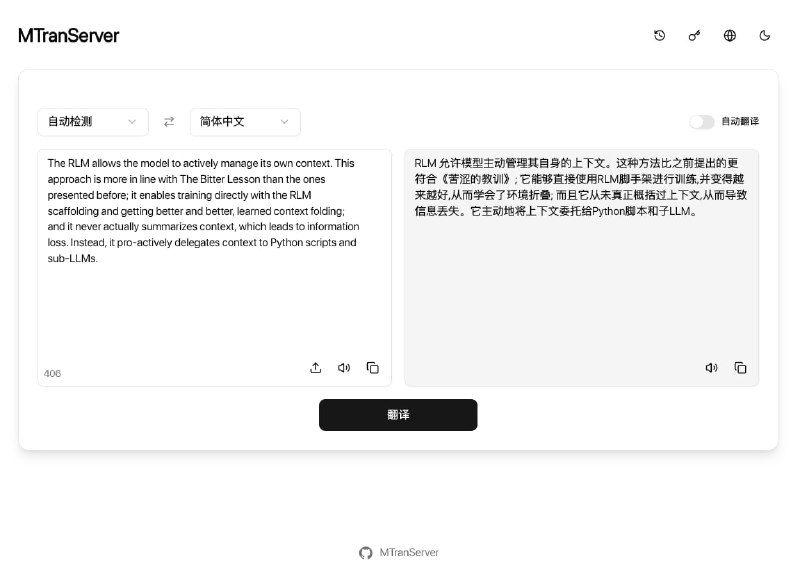
  10. MTranServer | 离线本地翻译

    一个超低资源消耗速度超快的离线翻译模型服务器,无需显卡。单个请求平均响应时间 50 毫秒。支持全世界主要语言的翻译。
    注意本模型服务器专注于离线翻译、响应速度、跨平台部署、本地运行 达到 无限免费翻译 的设计目标,受限于模型大小和优化程度,所以翻译质量肯定是不如大模型翻译的效果。需要高质量的翻译建议使用在线大模型 API。

    点击访问

    #开源 #本地翻译 #AI翻译
  11. 🔥 AI 圈大地震!3.5GB 模型性能干翻 Claude、Gemini?!🔥

    忘掉那些几十上百 GB 的庞然大物吧!一款名为 VibeThinker 的离线模型,正在颠覆我们对“强大”的认知!

    🚀 为什么说它是“核弹”?
    ✅ 性能逆天: 在多项基准测试中,击败了 Claude, Gemini, Qwen, DeepSeek 等所有顶级模型!
    ✅ 体积小到离谱: 整个模型只有 3.5 GB,比一部电影还小!
    ✅ 你的电脑就能跑: 无需顶级显卡,普通电脑甚至个人服务器就能轻松运行。
    ✅ 全能选手: 写代码、写文章、逻辑推理... 样样精通。

    这可能是实现“人人都能本地运行超强 AI”的第一步。

    → 前往 GitHub 探索项目
    → 前往 Hugging Face 下载模型

    频道 | 💬 群组 | 📬 投稿 | 📨 商务

    #AI #开源 #LLM #本地模型 #黑科技